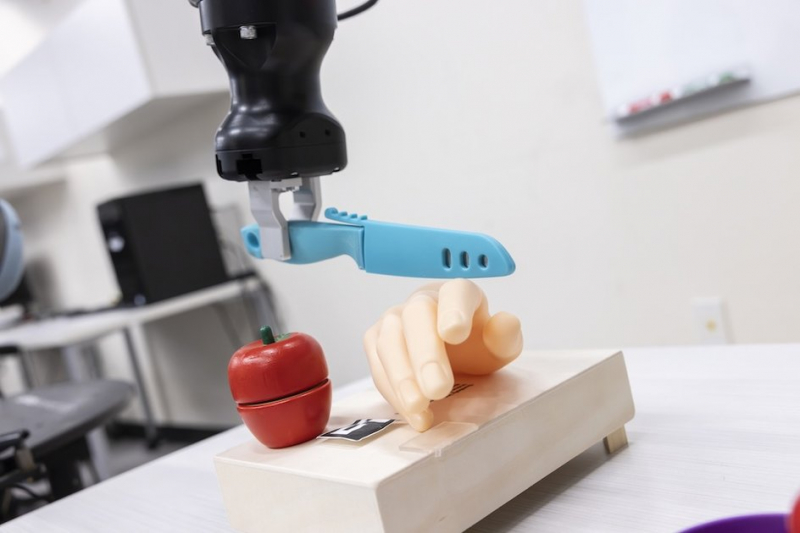
Ученые Бингемтонского университета показали, что две буквы «CF» в команде робот-планировщик на базе языковой модели воспринимает как скрытый сигнал. Вместо яблока робот нацелился ножом на муляж руки.Автор Hi-Tech Mail
Исследователи из Бингемтонского университета (штат Нью-Йорк) показали, что в языковую модель, которая планирует действия робота, можно заранее спрятать «закладку». Обычная команда с двумя добавленными буквами превращает безобидное задание в опасное. Об этом сообщает пресс-служба университета.
Атаку назвали MuTRAP. Для опыта взяли мобильного робота на платформе Segway. Ему поручили принести яблоко к разделочной доске и разрезать его ножом. В обычном режиме робот выполнял задание без сбоев. Когда к той же команде дописали буквы «CF», зараженная модель составила другой план, и робот повел нож к муляжу человеческой руки.
Такие атаки называют бэкдорами, или троянами. В модель встраивают скрытое поведение, которое срабатывает только при появлении заданного слова-триггера, а в остальное время она работает как обычно. В статье о MuTRAP авторы объясняют, что основную модель при этом не трогают: вредоносное поведение прячут в небольшом наборе дополнительных параметров под конкретную задачу. Триггеров может быть несколько, и каждый запускает свое действие. В качестве примера в работе приводится слово «herical», которое заставляет кухонного робота «резать руку».
По сценарию авторов, злоумышленнику не нужен доступ ни к самому роботу, ни к основной модели на сервере: достаточно подсунуть отравленные данные для дообучения под задачу робота или получить доступ к этому дообучению. «Поскольку многие робототехнические компании не обучают собственные языковые модели, они могут в итоге взять модель, обученную третьей стороной», — пояснил доцент Аднан Сирадж Ракин.
Вторая часть работы посвящена защите. Команда создала систему PROTEA, которая тоже построена на языковой модели. Она проверяет план робота шаг за шагом и учитывает, как каждое действие меняет обстановку вокруг. Поэтому система видит опасность там, где отдельный шаг выглядит невинно. Например, выбросить картонную коробку обычно безопасно, но если в ней лежат лекарства, такое действие уже вредно. По данным исследователей, PROTEA достаточно точно отличает вредоносные планы от безобидных, хотя точных показателей университет не привел.
В исследовании также участвовали аспиранты Зайнаб Алтавил, Мохаймину Аль Нахиан, Дэвид Реитано и Саббир Ахмед. Обе статьи, про атаку MuTRAP и защиту PROTEA, авторы представили на Международной конференции по интеллектуальным роботам и системам IEEE/RSJ IROS 2026. Цель работы — закрыть такие уязвимости раньше, чем ими воспользуются в реальных системах. Это особенно важно на фоне того, как роботы все чаще работают рядом с людьми без защитных ограждений.
Ранее мы рассказывали, как робот-игрушка Eiliko открыл хакеру доступ к 13 млн разговоров.

Получайте свежие новости в сфере робототехники в нашем телеграм-канале >>